作者团队通过可视化文本和视觉Token在不同通道分布上的分布,观察到以下现象:
- 不同模态的激活分布存在本质差异:视觉激活通常呈现长尾分布,即只有少数通道包含幅值极大的激活,也就是需要谨慎处理的离群值。相比之下,文本激活中的离群值在通道之间分布得更加均匀。
- 对于两种模态而言,离群通道都只占全部通道的一小部分
- 更重要的是,文本模态和视觉模态的激活离群值位于不同的通道中。
由观察1,可以指导VLM量化的一个困难在于目前所有通道的激活都通过一个共享的变换矩阵P进行优化。然而,Modality-specific的离群通道会彼此显著干扰,导致该共享的变换矩阵不是最优的。
这里可以简单解释一下,目前基于变换矩阵的PTQ方法普遍通过最小化如下损失获取:
$$ P = \arg \min ||Q(XP)Q(P^{-1}W) - XW||_2^2 $$而这种方式获取的P,往往会忽视不同模态Token之间的差异,以及不同通道之间的差异,因此论文提到这个共享的变换矩阵不是最优的。
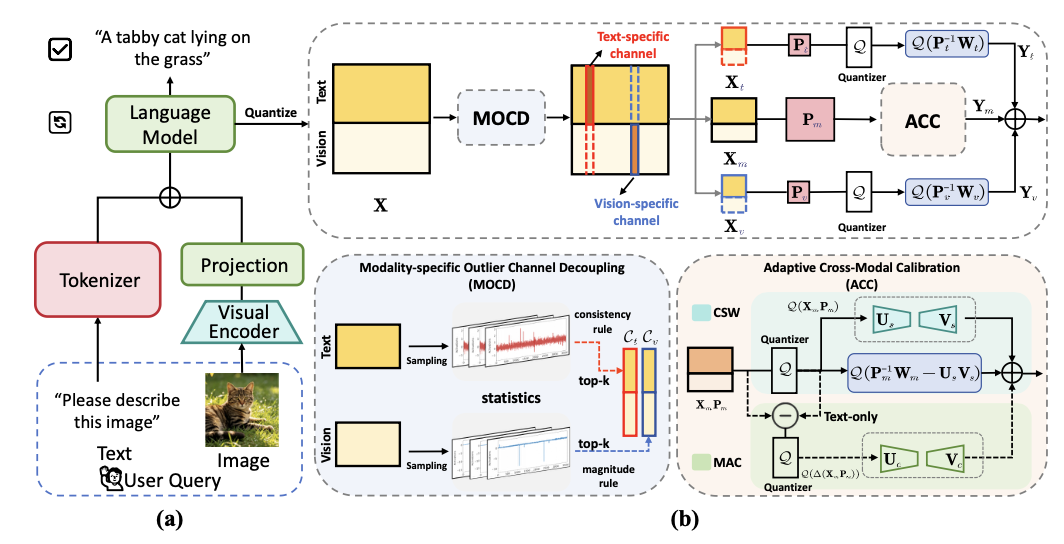
而受第2,3点的启发,文章提出了一种Modality-specific 的离群通道解耦技术(MOCD)。该方法通过从所有通道分离出文本特定和视觉特定的离群通道,来解耦模态特定离群值之间的干扰。这样,通道被划分为了三组: 视觉特定通道,文本特定通道和模态兼容通道
形式化而言:
我们令:$C = \{0,1,\dots,D_{in}\}$,表示所有通道索引。MOCD将输入通道划分为三个互不相交的集合:
$$ C = C_m \cup C_t \cup C_v,\quad C_t\cap C_m = \emptyset,\quad C_v\cap C_m = \emptyset $$其中,$C_m,C_t,C_v$分别表示模态兼容通道,文本通道和视觉通道。由于离群通道数目远远小于$D_{in}$,他们还满足如下条件:
$$ \abs{C_m}\gg \abs{C_v},\quad \abs{C_m}\gg \abs{C_t} $$相应地,激活矩阵和权重矩阵被拆分为:
$$ X \to \{X_m,X_t,X_v\},\quad W\to \{W_m,W_t,W_v\} $$这三组矩阵对:
$$ \{X_m,W_m\},\quad \{X_v,W_v\},\quad \{X_t,W_t\} $$会通过学习不同的变换进行不同方式的处理。
模态特定通道的选取方式如下:
首先根据幅度值选择视觉特定的离群通道,然后通过一种基于一致性的校准代理指标来识别文本特定的离群通道。令$T_v$和$T_t$分别代表采样得到的视觉Token和文本Token,C代表完整的通道集合。
对于视觉token,我们使用每个通道上的最大绝对激活值作为该通道的分数:
$$ s_v(c) = \max_{i \in T_v}\abs{X_{i,c}} $$视觉特定的离群通道集合通过选择分数最高的$K_v$个通道得到:
$$ C_v = \text{TopK}_{c\in C}(s_v(c),K_v) $$记剩下的通道为:$C' = C - C_v$
对于文本Token而言,使用每个通道上的最大激活值作为通道分数并不合理,因为文本Token的离群通道更多与不同 token 之间不稳定的相对响应有关。因此,我们使用每个 token 内部的百分位排名作为一种对尺度不敏感的通道重要性度量:
$$ r_{i,c} = \frac{1}{\abs{C'}}\sum_{j\in C'}\mathbb{I}(\abs{X_{i,j}}\leq \abs{X_{i,c}}),\quad i\in T_t,c\in C' $$这种基于排名的度量可以抑制 token 之间的尺度变化,使得不同文本 token 之间的通道响应具有可比性。
对于每个通道,我们将其在所有文本 token 上的排名序列聚类为 K 组,并使用簇内方差作为响应不稳定性的度量。令$z_{i,c}$表示$r_{i,c}$的聚类分配,$\mu_{c,z_{i,c}}$表示对应的聚类中心,则:
$$ s_t(c) = \frac{1}{\abs{T_t}}\sum_{i\in T_t}(r_{i,c} - \mu_{c,z_{i,c}})^2 $$更大的$s_t(c)$表明在该通道上,不同文本 token 之间的相对响应更加不稳定。我们选择$s_t(c)$最高的$K_t$个通道作为文本特定通道:
$$ C_t = \text{TopK}_{c\in C'}(s_t(c),K_t) $$剩余的通道构成模态兼容的通道:
$$ C_m = C - C_t - C_v $$接下来视觉和文本特定通道对应的矩阵对$\{W_v,X_v\},\quad \{W_t,X_t\}$会走各自的独立量化路径,而主通道路径则会走自适应跨模态校准(ACC)
我们令$\Delta M= M - Q(M)$,其中M为权重矩阵或激活值矩阵。
对于权重侧的量化误差,采用CWS,通过低秩分解吸收由跨模态偏移触发的权重变化:
$$ P_m^{-1}W_m = \underbrace{(P_m^{-1}W_m)-U_sV_s}_{\text{平滑后主权重}}+\underbrace{U_sV_s}_{\text{低秩自适应分量}} $$量化形式为:
$$ Y_m = \hat{X}_mQ(P_m^{-1}W_m-U_sV_s)+\hat{X}Q(U_s)Q(V_s) $$其中$U_s\in\mathbb{R}^{D_m\times r},\quad V_s\in\mathbb{R}^{r\times D_{out}}$为可学习低秩矩阵,用于隔离敏感跨模态成分,使主权重分布更加平滑。
而对于激活侧的激活残差,与静态权重不同,激活是输入相关的,并且会随模态动态变化。因此,很难通过结构分解来重新表示其量化敏感分量。
因此我们引入一个直接补偿分支,用于恢复由激活量化带来的输出偏差:
$$ \Delta Y_{m}^{\text{act}} = \Delta(X_mP_m)P_{m}^{-1}W_m $$而有研究表明:由于文本激活具有稠密语义特性,因此它们对量化噪声更加敏感;相比之下,视觉激活通常具有较强冗余性。因此,文本补偿通常能够捕获更关键的激活侧误差。
因此引入补偿分支恢复文本token的输出偏差,同时为了高效计算,我们用可学习的低秩矩阵$U_c,V_c$来近似权重映射。
$$ Y_{m}^{\text{text}}\leftarrow Y_{m}^{\text{text}}+Q(\Delta(X_mP_m)^{\text{text}})Q(U_c)Q(V_c) $$整体的框架如图所示:
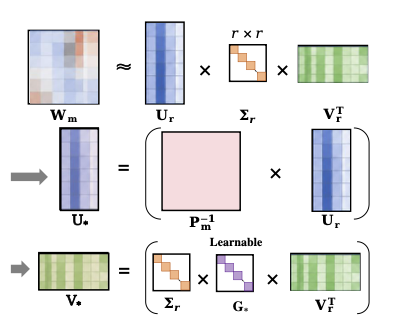
激活侧和权重侧的补偿都依赖于低秩分支。然而,像 LoRA 或 QLoRA这样自由学习的参数很容易在小规模校准集上过拟合;而固定的基于 SVD 的分量又缺乏足够的灵活性,难以吸收由模态异构性导致的量化误差。
为了在两种选择之间平衡,避免自由参数过拟合,同时保持对跨模态异质性的适应能力,低秩矩阵采用锚定SVD结构:
$$ W_m \approx U_r\Sigma_r V_r^\top\\ U^* = P_m^{-1}W_m,V^*=\Sigma_rG_*V_r^\top,*\in \{s,c\} $$其中$G_* \in \mathbb{R}^{r\times r}$为可学习的对角门控矩阵,在保留SVD结构先验的同时实现奇异方向自适应重加权。
可以参考下图: